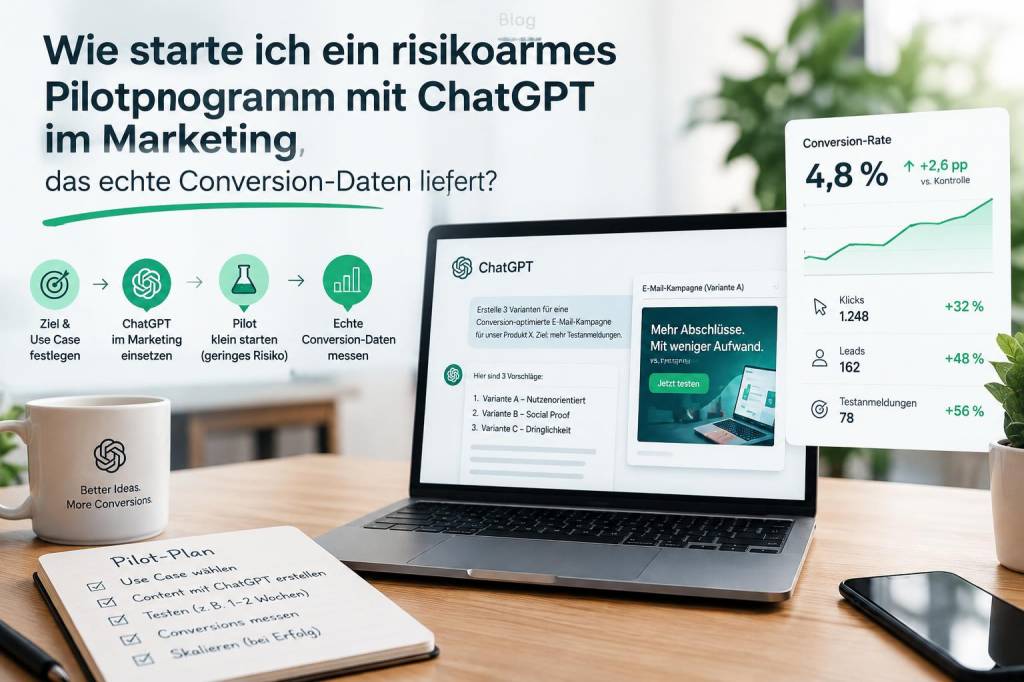
Marketing-Teams stehen heute vor der Herausforderung, KI-gestützte Tools wie ChatGPT schnell zu testen — ohne große Budgets oder riskante Änderungen an bestehenden Kampagnen. Ich beschreibe hier, wie ich ein risikoarmes Pilotprogramm mit ChatGPT aufsetze, das nicht nur Experimente erlaubt, sondern echte Conversion‑Daten liefert. Mein Ziel: klare Hypothesen, saubere Messbarkeit und schnelle Entscheidungsgrundlagen.
Warum ein strukturierter Pilot statt „einfach mal ausprobieren“?
Ich sehe immer wieder, dass „KI ausprobieren“ endet in verstreuten Tests ohne klare Ziele. Das Ergebnis: keine belastbaren Daten, kein Lerngewinn. Ein strukturierter Pilot reduziert Risiko, schützt Markenimage und schafft messbare Erkenntnisse. Für mich bedeutet das: vorher definieren, wie Erfolg aussieht, wie Daten erhoben werden und welche Sicherheits- oder Compliance‑Grenzen es gibt.
Schritt 1 — Zieldefinition und Hypothesen
Jeder Pilot startet bei mir mit klaren Zielen. Möchte ich mehr Leads, höhere Klickrate (CTR), bessere Conversion Rate auf Produktseiten, oder soll ChatGPT den Sales-Support entlasten? Daraus formuliere ich präzise Hypothesen, z.B.:
Hypothesen müssen messbar sein (Metrik, Zielwert, Zeitraum) — das ist die Basis für valide Entscheidungen.
Schritt 2 — Auswahl der Use-Cases (low-risk, high-learning)
Ich priorisiere Use-Cases nach Risiko und Lernenpotenzial. Für einen ersten Pilot wähle ich typischerweise:
Ich vermeide zunächst sensible Inhalte (rechtliche Beratung, Medizin, Finanzberatung) und persönliche Kundenkommunikation mit hohem Schadenpotenzial.
Schritt 3 — Experimentdesign und Traffic-Allokation
Ein sauberes Design ist essenziell. Ich arbeite meist mit A/B- oder Multivariaten Tests und halte folgende Regeln ein:
Beispiel: Für eine Landingpage‑Conversion starte ich mit 70 % Kontroll-CTA, 30 % ChatGPT‑CTA. Wenn erste Signale positiv sind, erhöhe ich die Allokation schrittweise.
Schritt 4 — Prompt-Engineering und Varianten
Die Qualität der Ausgaben hängt an den Prompts. Ich erstelle mehrere, differenzierte Prompts und nutze systematische Variation:
Ich speichere die Prompts, Input‑Outputs und Metadaten in einem Tracking‑Sheet (z. B. Google Sheets oder Notion). So ist Nachvollziehbarkeit gegeben — wichtig für Compliance und spätere Optimierung.
Schritt 5 — Tracking, Attribution und Datenqualität
Gute Messbarkeit ist die Achillesferse vieler Experimente. Ich stelle sicher:
Wichtig: Wenn ChatGPT Nutzerdaten verarbeitet, kläre ich vorab Datenschutzfragen (DSGVO), leite keine personenbezogenen Daten an die API und dokumentiere Datenflüsse.
Schritt 6 — Laufzeit, Signifikanz und Entscheidungskriterien
Ich definiere vor Start, wie lange der Test laufen muss und ab welchem Punkt ich entscheide. Typisch sind 2–6 Wochen, abhängig vom Traffic. Entscheidungsregeln lege ich fest:
Wichtig ist für mich, nicht nur auf p‑Werte zu starren, sondern auch auf Business‑KPIs: Leadqualität, CPL, Customer Lifetime Value.
Schritt 7 — Monitoring und Qualitätskontrolle
Während des Runs überwache ich:
Bei Auffälligkeiten setze ich automatisierte Alerts (z. B. Slack/Teams via Zapier) und stoppe den Test, falls negative Markenwirkung droht.
Schritt 8 — Auswertung und Learning-Report
Nach Abschluss erstelle ich einen kompakten Report mit:
Ich dokumentiere auch technische Lessons (z. B. nötige API‑Limitierungen) und passe SOPs an.
Praxisbeispiel: E‑Mail-Betreffzeilen
| Hypothese | ChatGPT‑generierte Betreffzeilen erhöhen Öffnungsraten um 8 % |
| Design | A/B-Test: 60 % Kontroll, 40 % ChatGPT-Varianten; Laufzeit 3 Wochen |
| Metriken | Open Rate, Click‑Through‑Rate, Unsubscribe‑Rate |
| Prompt‑Beispiel | „Erzeuge 6 Betreffzeilen für ein Produkt-Update, Ton: neugierig & knapp, max. 45 Zeichen“ |
Dieses Setting gab mir schnell klare Zahlen — und oft überraschende qualitative Hinweise, welche Formulierungen Vertrauen schaffen oder als spammy wahrgenommen werden.
Rechtliches & Datenschutz
Ich prüfe vor jedem Pilot:
Im Zweifel schalte ich die Rechtsabteilung oder externe Datenschutzberater ein — das kostet wenig im Vergleich zu einem Reputationsschaden.
Skalierung oder Abbruch — die wirtschaftliche Sicht
Wenn Conversion‑Gewinne real sind, plane ich Skalierung iterativ: erhöhe Traffic, automatisiere Prompt‑Pipelines und integriere die besten Varianten in den normalen Produktionsworkflow. Falls Ergebnisse enttäuschen, nutze ich die gewonnenen Daten, um Ursachen zu analysieren (Targeting, Traffic-Qualität, Prompt‑Formulierung) — und entscheide dann über einen Folgeversuch oder Abbruch.
Ein risikoarmes Pilotprogramm mit ChatGPT funktioniert für mich über klare Ziele, sauberes Experimentdesign, striktes Tracking und pragmatische Governance. So entstehen belastbare Erkenntnisse — und echte Conversion‑Daten, auf denen ein skalierbarer Einsatz gebaut werden kann.